电子系统的复杂度并非均匀分布,而是沿着抽象层级逐级膨胀。每一层向上,状态空间大约扩张一个数量级——这是我们在此前讨论 τ 定律(Tau Scaling Law)时已经给出的判断。时间维度同样遵循这一规律:信号从 NAND 门出发,经过组合逻辑、流水线、指令调度、虚拟机分发、运行时管理,最终抵达用户界面的过程中,延迟的成因、量级与控制手段发生了根本性的变化。本文尝试为这一变化建立一套系统化的分析框架,即多层电子系统中的时间标度理论。
什么是时间标度理论
时间标度理论(Time Scaling Theory)关注的核心问题是:在一个多层抽象的电子系统中,时间特性如何随层级变化而呈现可预测的标度行为。
传统的时序分析通常局限于单一层级——芯片设计者关心门延迟与建立时间,编译器工程师关心指令调度窗口,系统架构师关心端到端延迟。这种分层孤立分析的方式在系统规模较小时尚可运作,但当现代计算系统横跨七个抽象层级(L1 基础逻辑门至 L7 应用抽象)时,单层级的分析已经无法解释一个请求从发出到返回所经历的全部时间构成。
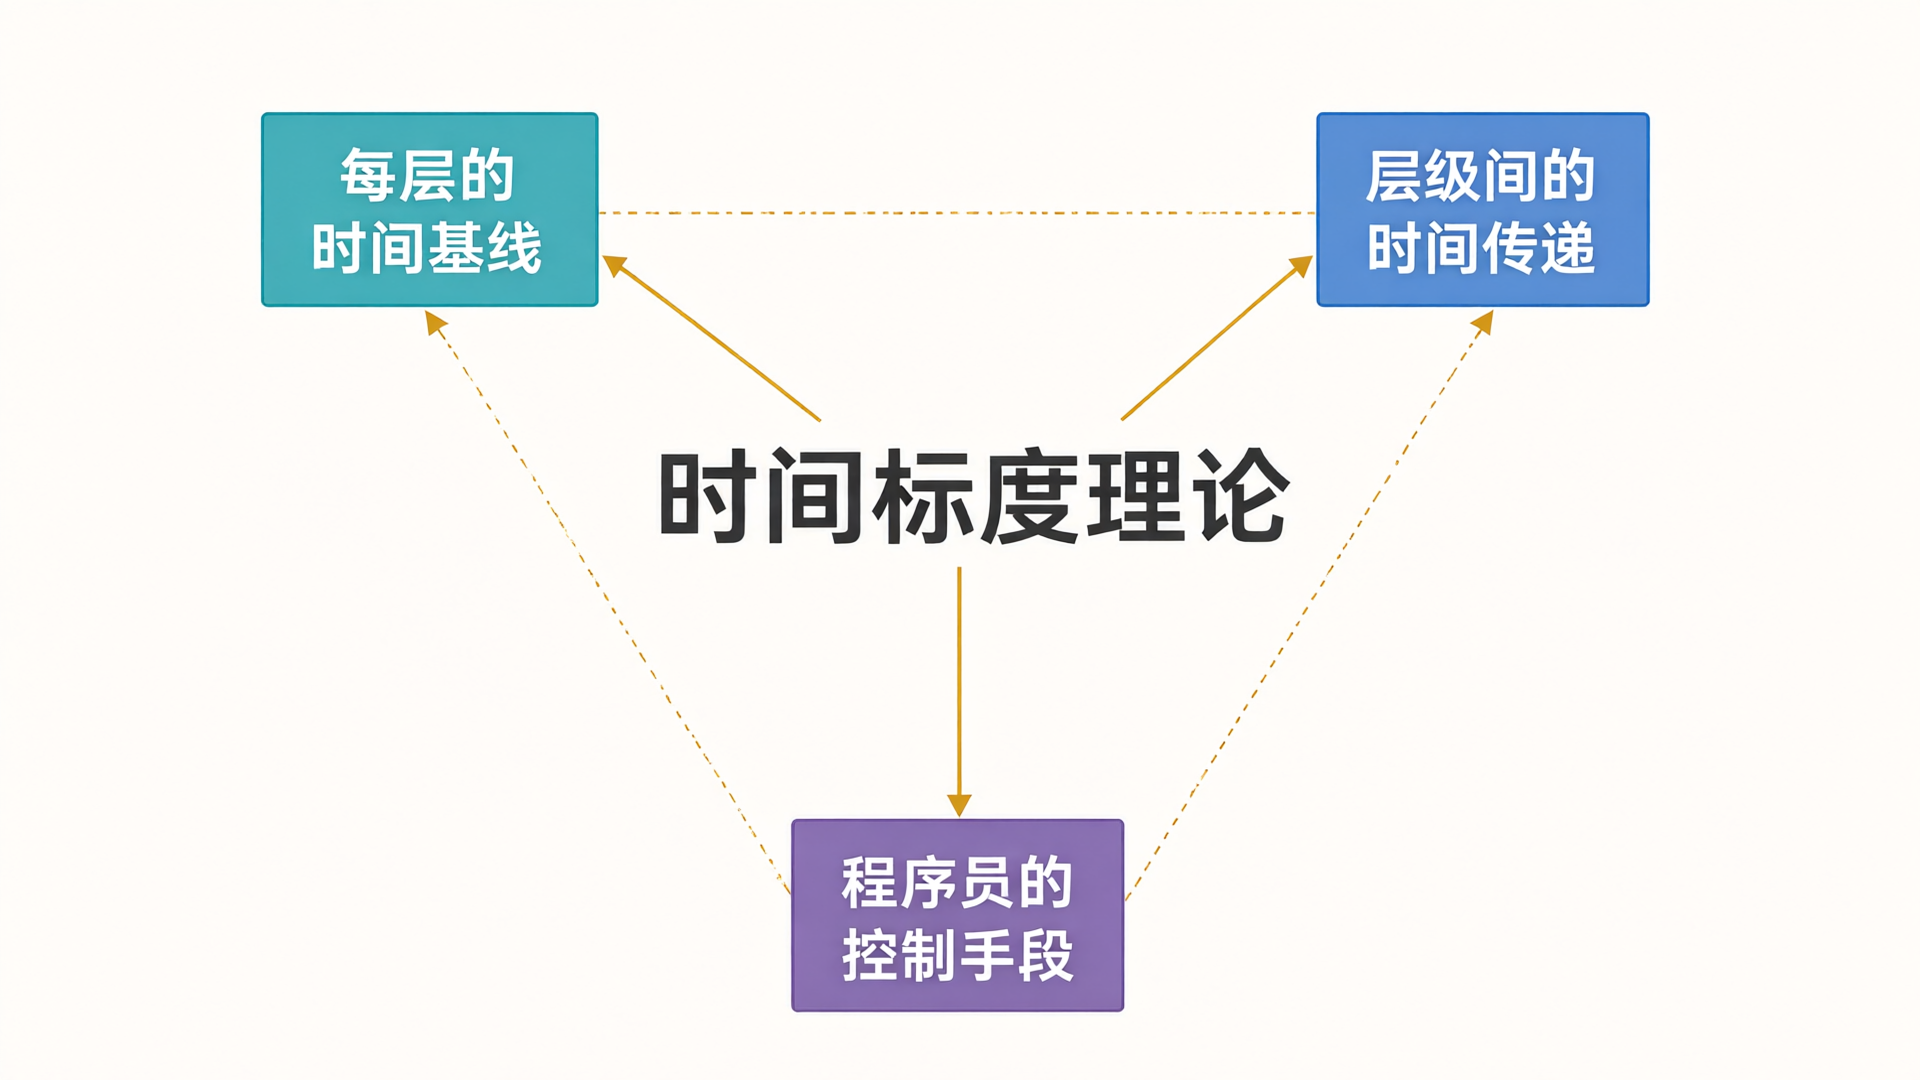
时间标度理论要求我们建立跨层级的时间模型。具体而言,它需要回答三个问题:每一层的时间基线是什么,层级间的时间如何传递与放大,以及程序员在每一层可以采取哪些手段来控制系统的时间行为。
七层抽象中的时间标度
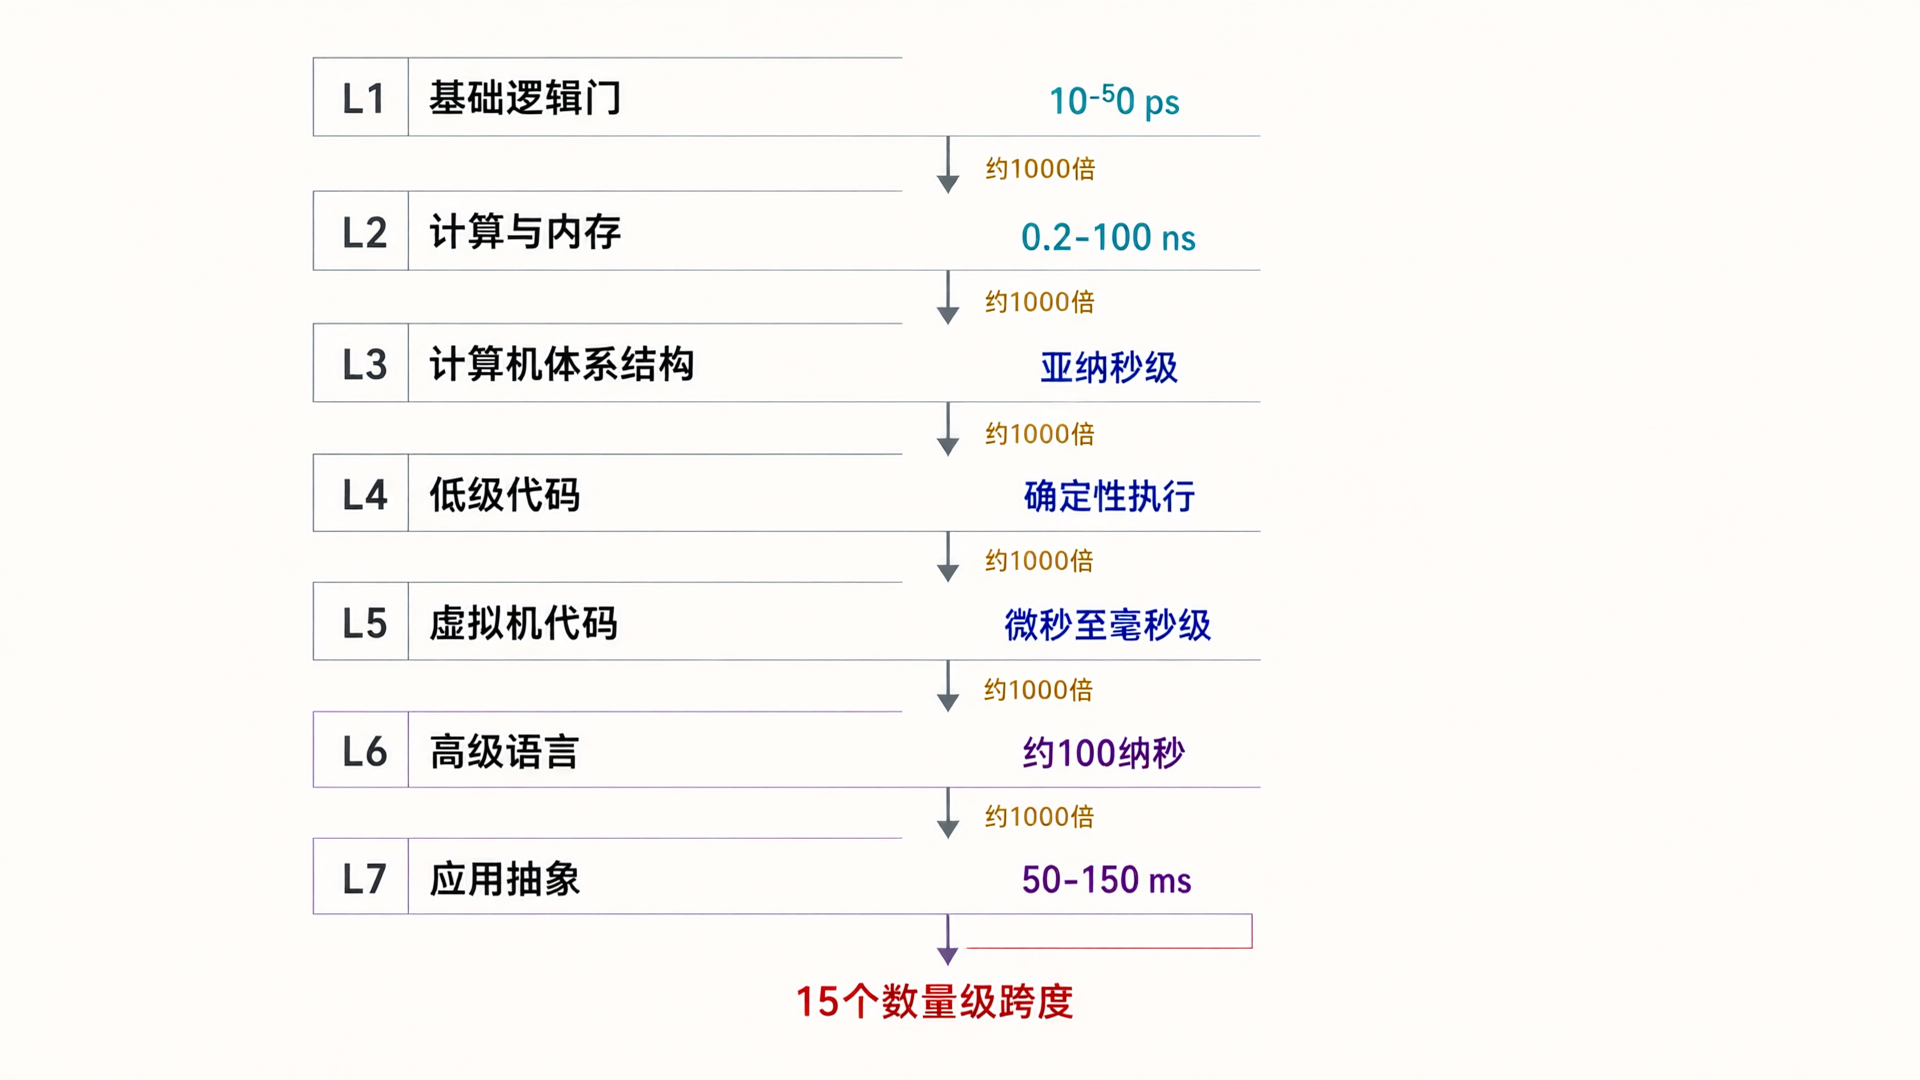
从 L1 到 L7,时间标度呈现出清晰的阶梯特征。每一层的时间基线由该层的物理约束或工程实现决定,层级间的时间传递则受到抽象机制的调制。
L1 基础逻辑门:物理极限下的皮秒世界
时间的基本单位是门延迟。一个 NAND 门的传播延迟在现代工艺(如台积电 3nm)下约为 10-50 皮秒。这一量级由载流子迁移率、栅极电容与互连线 RC 延迟共同决定。数十亿个逻辑门通过组合与时序逻辑构成完整的运算单元,其时间特性由关键路径(critical path)决定——即信号从输入到输出所需的最长传播路径。
这一层的时间标度受物理约束支配。信号在硅中的传播速度上限约为光速的三分之一(约 10^8 m/s),这意味着 1 毫米的互连线就会引入约 10 皮秒的延迟。当芯片尺寸达到厘米级时,互连延迟已成为不可忽视的因素。现代处理器通过层次化时钟树设计与流水线切分来应对这一约束。
L2 计算与内存:两个数量级的速度鸿沟
时间单位上升到时钟周期。CPU 主频 2-5 GHz 对应 0.2-0.5 纳秒的周期长度,而 DDR5 内存访问延迟约为 100 纳秒量级,二者相差两个数量级。这一差距源于 DRAM 的物理机制——电容充放电需要时间,而行地址与列地址的分时复用进一步增加了访问延迟。
GPU 侧的情况更为极端。H100 的 HBM3e 显存带宽达到 3.35 TB/s,但这是通过 5 层 HBM 堆叠与 1024-bit 位宽实现的并行带宽,单次访问延迟仍在数百纳秒量级。计算与存储之间的速度鸿沟是这一层时间标度的核心矛盾,也是缓存层次结构存在的根本原因。
L3 计算机体系结构:调度策略塑造的时间维度
超标量流水线、乱序执行与 Warp 调度引入了时间维度的并行化。现代 CPU(如 Intel Core i9)可以在一个周期内发射 6-8 条指令,通过重排序缓冲区(ROB)与保留站(reservation station)实现指令级并行。GPU 则通过 Warp 调度器在内存等待期间切换到其他 Warp,以线程级并行隐藏延迟。
这一层的时间标度不再由单一信号路径决定,而是由调度策略与资源竞争共同塑造。缓存命中率、分支预测准确率、Warp 占用率等指标成为影响时间行为的关键变量。
L4 低级代码:确定性执行的最后阵地
程序员通过汇编指令直接控制处理器的时间行为。一条整数加法指令的延迟是固定的(通常 1-3 个周期),乘法指令约为 3-5 个周期。循环展开可以减少分支开销,指令重排可以优化流水线利用率,寄存器分配可以减少内存访问次数。
这一层的时间标度具有确定性——给定硬件配置与输入数据,执行时间可以精确预测。这也是实时系统(如航空电子、汽车控制)必须在 L4 或更低层级实现的原因。
L5 虚拟机代码:非确定性开销的涌现
JIT 编译、垃圾回收与运行时分发引入了非确定性的时间开销。JVM 的 GC 暂停可达数十毫秒(G1 收集器的 Full GC 甚至可达秒级),CUDA Runtime 的 kernel launch 开销约为 5-10 微秒。这些开销在单次调用中看似微小,但在高频调用场景下会累积成显著的时间成本。
这一层的时间标度开始出现突变——大部分时间花在少数不可预测的事件上。长尾延迟(tail latency)成为这一层的典型特征,P99 延迟可能是 P50 的数十倍甚至上百倍。
L6 高级语言:运行时设计的隐性成本
编译器优化、自动微分框架与解释器开销构成了新的时间维度。Python 的一次函数调用开销约为 100 纳秒(主要来自字典查找与类型检查),PyTorch 的自动微分在反向传播时可能引入额外的内存分配与内核启动延迟。Rust 的零成本抽象则通过单态化(monomorphization)与内联优化在编译期消除大部分运行时开销。
这一层的时间标度高度依赖语言实现与运行时设计。同一算法在 Python、Java、Rust 三种语言中的执行时间可能相差两个数量级。
L7 应用抽象:系统间协调的时间主导
网络延迟、分布式一致性与序列化开销成为时间的主要来源。一次跨区域的 RPC 调用延迟约为 50-150 毫秒(受光速限制,跨太平洋往返约 150 毫秒),分布式事务的提交时间取决于最慢节点的响应速度。序列化格式的选择(Protobuf vs JSON)也会影响 10-30% 的编码延迟。
这一层的时间标度已经脱离了单个处理器的范畴,进入系统间协调的领域。CAP 定理表明,在分区容忍的前提下,一致性与可用性不可兼得——这一理论约束直接决定了分布式系统的时间行为上限。
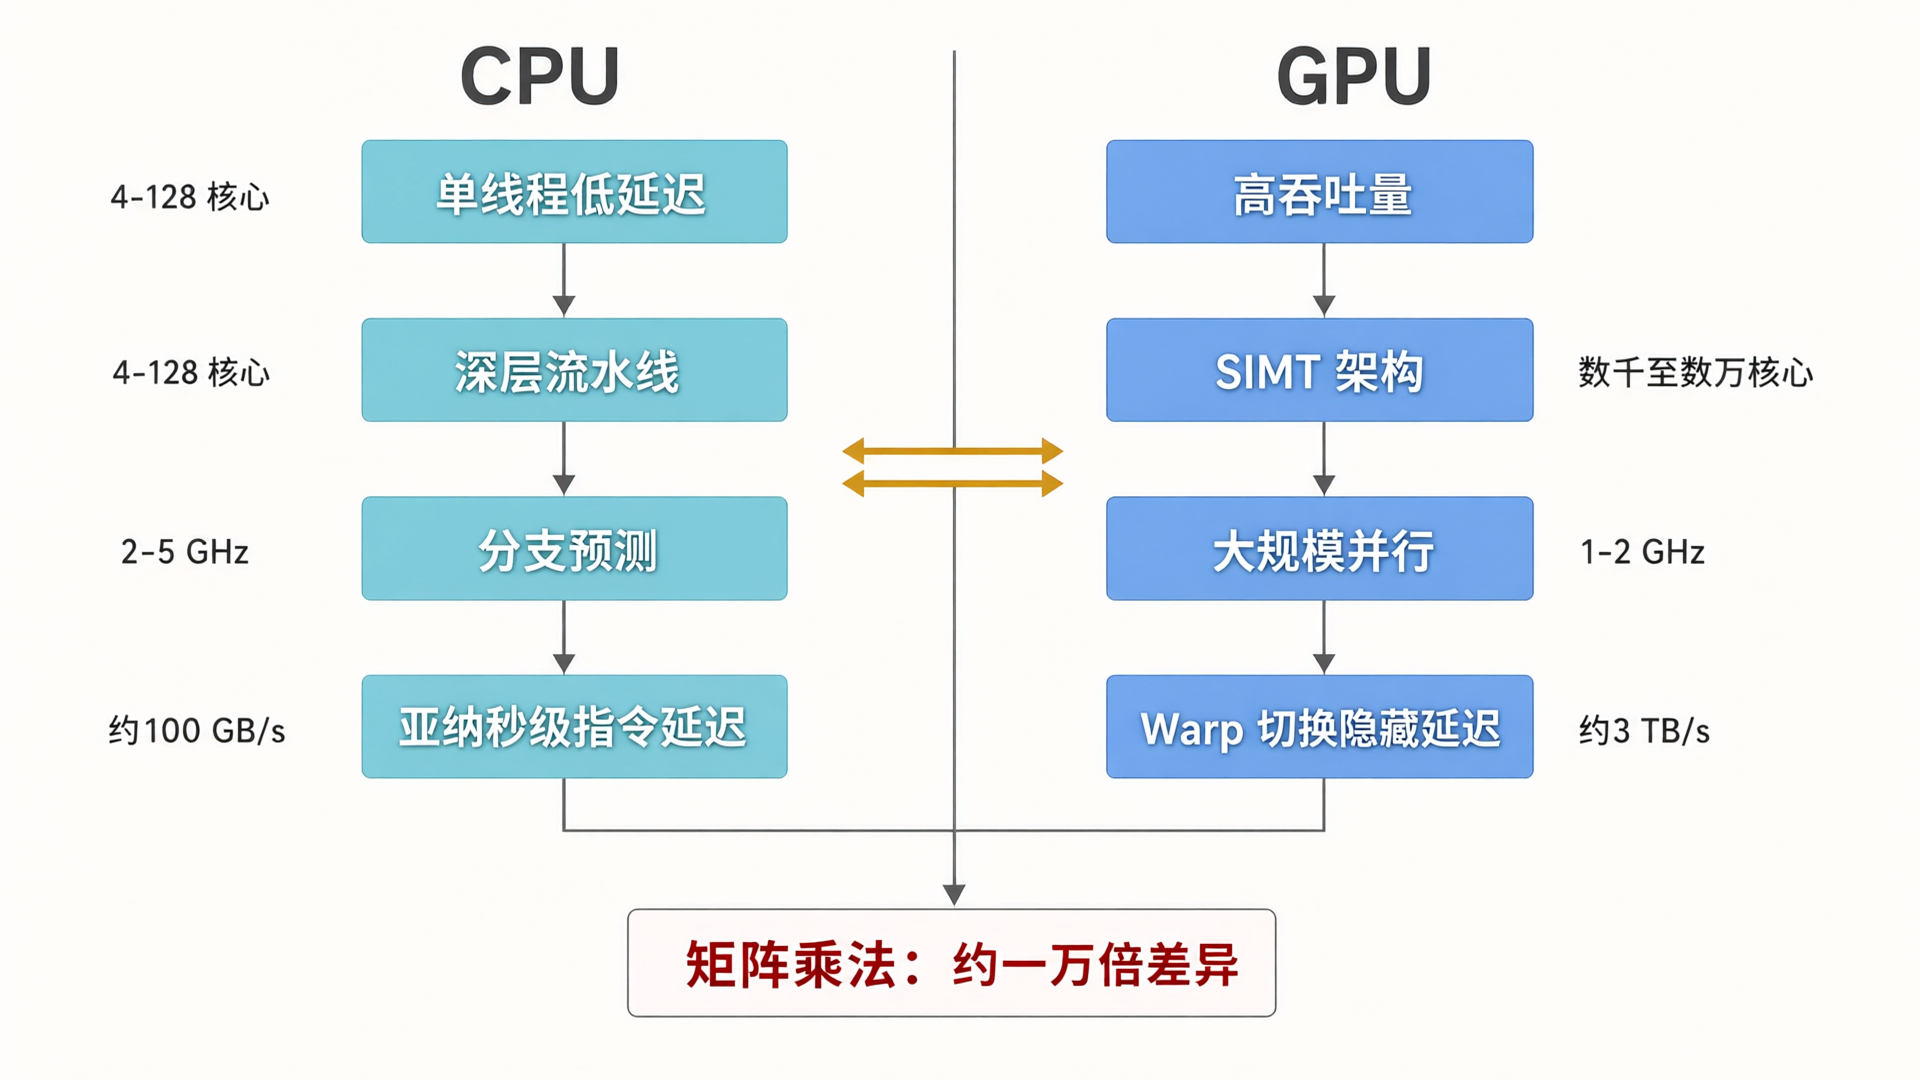
CPU 与 GPU 的时间标度对比
同一层级内,CPU 与 GPU 的时间标度行为存在显著差异。CPU 追求单线程的低延迟,通过深层流水线与分支预测将指令级延迟压缩到亚纳秒级别。GPU 追求高吞吐量,通过 SIMT 架构与大规模并行将单请求延迟换取整体带宽。以矩阵乘法为例,CPU 的优化实现(如 OpenBLAS)在单核上可以达到数十 GFLOPS,而 GPU(如 H100)通过 Tensor Core 可以实现近 1000 TFLOPS 的峰值算力——二者相差四个数量级,但单个元素的计算延迟 GPU 未必占优。
这种差异意味着,在跨层级分析时间标度时,不能简单地将 CPU 的时序模型套用到 GPU 上,反之亦然。
工程实践中的陷阱
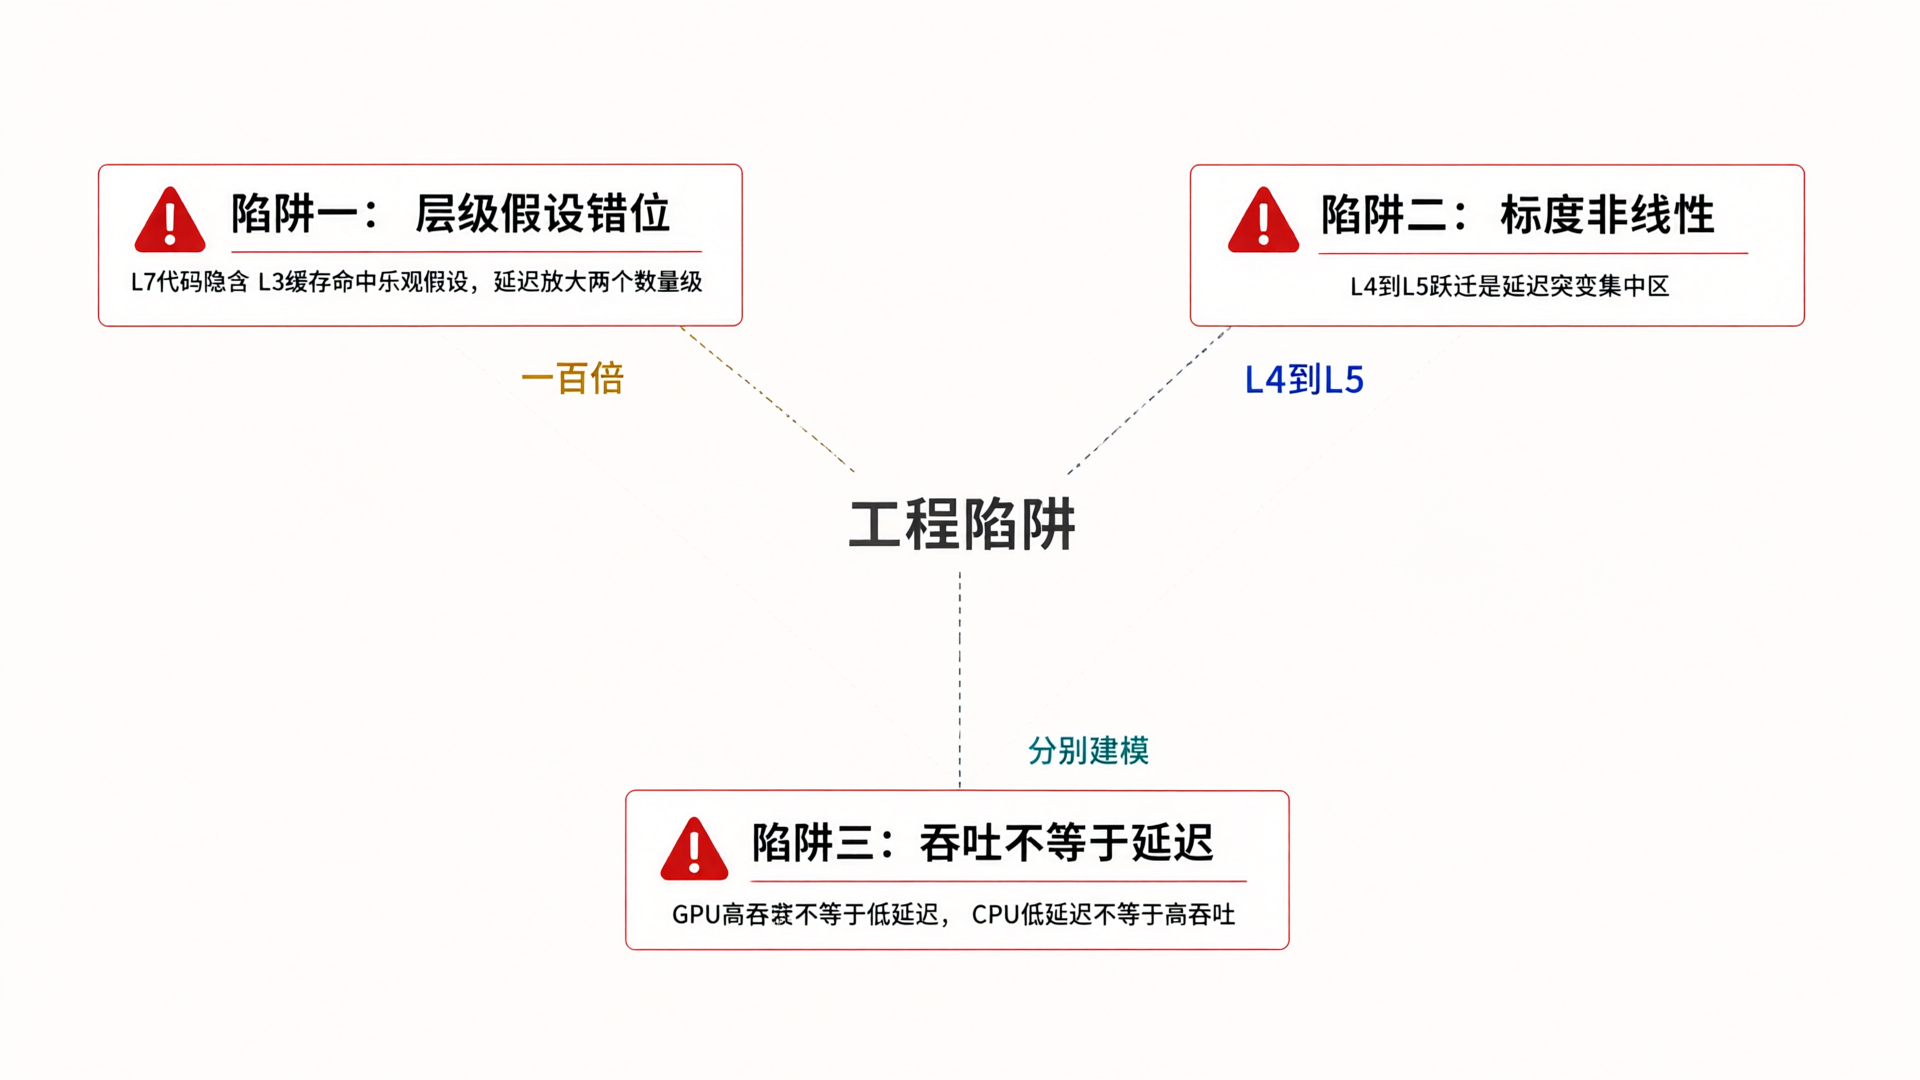
时间标度理论在工程实践中揭示了几类常见陷阱。
第一类陷阱是层级间的时间假设错位。开发者在 L7 层编写的代码可能隐含了对 L3 层缓存命中率的乐观假设,而实际运行时缓存未命中导致的延迟放大可能超出预期两个数量级。
第二类陷阱是忽视时间标度的非线性。从 L1 到 L7,时间量级跨越了约 15 个数量级(从皮秒到百毫秒),但层级间的放大效应并非均匀分布。L4 到 L5 的跃迁(从确定性执行到运行时开销)往往是延迟突变的集中区域。
第三类陷阱是将吞吐量与延迟混为一谈。GPU 的高吞吐量并不意味着低延迟,CPU 的低延迟也不意味着高吞吐量。在系统设计中,二者需要分别建模、分别优化。
结语
时间标度理论为多层电子系统提供了一套跨层级的分析工具。它要求工程师在审视时间特性时,不局限于当前所在的抽象层级,而是建立从物理信号到应用请求的完整时间链路认知。这种认知不是理论推演的产物,而是工程实践中反复验证的经验总结。